Ratgeber
SLA-Reporting: Verlässliche Basis für Servicequalität und Steuerung
·8 Min. Lesezeit·digitalWAS solutions·Mit KI erstellt
 KI-generiertes Bild
SLA-Reporting liefert die verlässliche Übersicht über Verfügbarkeit und SLO-Einhaltung, die IT- und Serviceverantwortliche zur Steuerung und Nachweisführung brauchen. Ein guter Bericht zeigt Uptime, Antwortzeit und MTTR auf einen Blick und macht Abweichungen sofort sichtbar. Das Ergebnis: fundierte Entscheidungen, frühzeitige Warnungen bei drohenden Verstößen und ein belastbarer Nachweis gegenüber Management und Kunden.
Kurz gesagt:
- Ein SLA-Bericht sollte die Verfügbarkeit, MTTR, First-Response-Zeit und Fehlerquote separat messen, um Abweichungen frühzeitig sichtbar zu machen.
- Die Datenquellen für das SLA-Reporting müssen zentralisiert und automatisiert sein, um feudale Diskrepanzen zwischen Provider und Kunde zu vermeiden.
- Die Evaluation erfolgt mittels request-based oder window-based Methoden, wobei Trend- und Klipp-Alarmmeldungen Frühwarnungen vor Verletzungen liefern.
- Fehlerquellen sind falsche Zeitfenster, Datenfragmentierung und fehlende Reproduzierbarkeit, welche durch regelmäßige Reviews vermieden werden können.
- Ein standardisiertes Template umfasst Zusammenfassungen für Management und operative Teams, mit klaren Verantwortlichkeiten und Berichtszyklen.
Inhaltsverzeichnis
- Was ist SLA-Reporting und wie unterscheidet es sich von SLA, SLO und KPI?
- Welche Kennzahlen gehören in einen SLA-Bericht?
- Woher kommen die Daten und welche Werkzeuge sichern die Qualität?
- Wie werden SLIs, SLOs und das Fehlerbudget im Bericht dargestellt?
- Welche Fehler schleichen sich in SLA-Berichte ein und wie lässt sich das vermeiden?
- Wie sieht ein praktisches Template für SLA-Berichte aus?
- Wie vereinheitlicht digitalWAS Reporting-Daten in der Praxis?
- Warum SLA-Reporting allein nicht reicht
- Diskrete Lösung: SLA-Reporting mit digitalWAS umsetzen
- Quellen
- FAQ
Was ist SLA-Reporting und wie unterscheidet es sich von SLA, SLO und KPI?
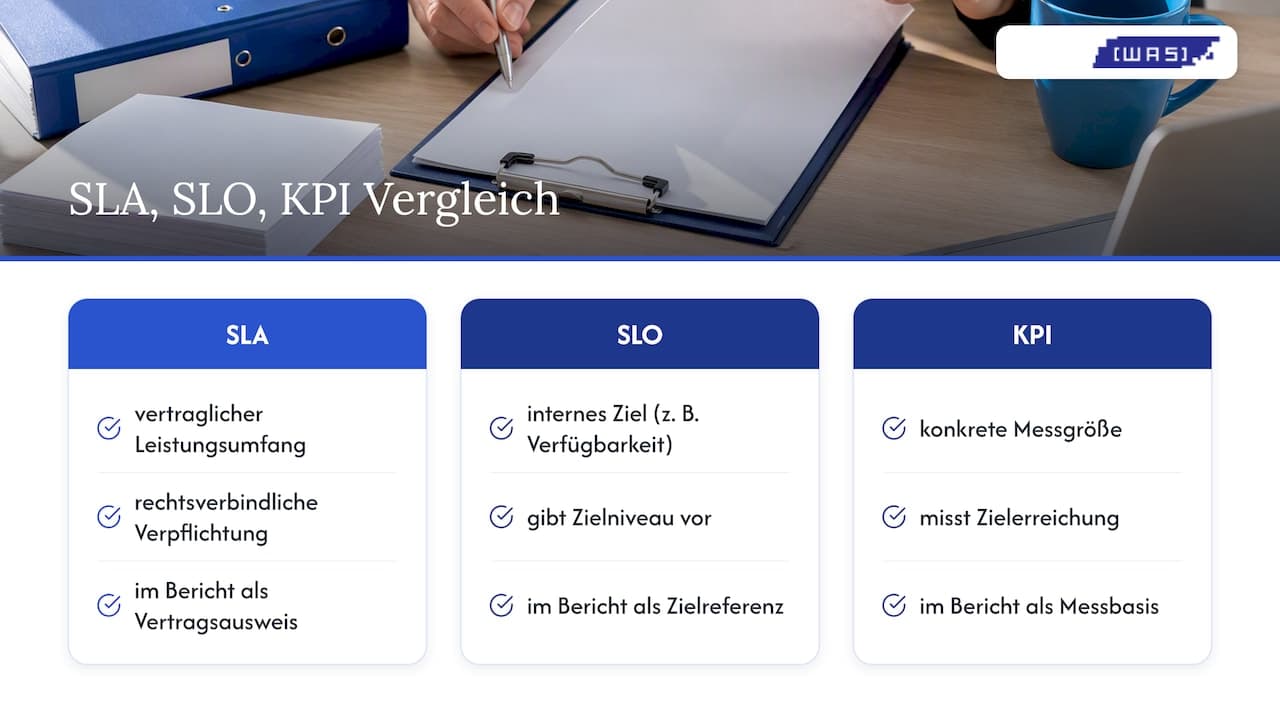
Ein Service Level Agreement ist zunächst ein Vertrag: Anbieter und Kunde legen darin fest, welche Leistung geschuldet wird. Laut Wikipedia ist das SLO dagegen ein internes Ziel, etwa sehr hohe Verfügbarkeit, während der KPI die konkrete Messgröße ist, mit der dieses Ziel überwacht wird. SLA-Reporting ist die Praxis, diese drei Ebenen regelmäßig zu dokumentieren und daraus verständliche Berichte zu erstellen.
 KI-generiertes Bild
Diese Abgrenzung wirkt trocken, verhindert aber handfeste Konflikte. Wird ein SLO in einem Bericht plötzlich wie ein KPI behandelt, oder umgekehrt, entstehen Streitigkeiten über die tatsächliche Zielerreichung. Die ISO/IEC 19086 liefert hierzu ein anerkanntes Rahmenwerk für Cloud-SLA-Metriken. Die Norm empfiehlt dabei kein starres Metrikset, sondern ein Modell, das auf den jeweiligen Dienst zugeschnitten wird. Wer SLA, SLO und KPI von Anfang an sauber trennt, spart sich spätere Diskussionen darüber, was ein Bericht eigentlich beweist.
Welche Kennzahlen gehören in einen SLA-Bericht?
Service Level Indicators bilden das Fundament jedes Reports. Verfügbarkeit, Latenz und Fehlerquote messen unterschiedliche Dinge und sollten nie zu einer einzigen Zahl vermischt werden.
- Uptime (%): Anteil der Zeit, in der ein Dienst innerhalb des vereinbarten Fensters erreichbar war.
- MTTR: Mittlere Zeit bis zur Wiederherstellung nach einem Ausfall, ein zentraler Indikator für die Reaktionsfähigkeit des Betriebsteams.
- First-Response-Zeit: Zeit bis zur ersten Rückmeldung nach Ticket-Eingang, oft getrennt von der eigentlichen Lösungszeit ausgewiesen.
- Error-Rate: Anteil fehlerhafter Anfragen oder Transaktionen im Verhältnis zur Gesamtmenge.
Eine reine Durchschnittsbetrachtung über 24 Stunden verzerrt oft das Bild. Wichtiger ist eine gewichtete Verfügbarkeit, die nur das vereinbarte Business-Fenster berücksichtigt, etwa die Kernarbeitszeit eines Kunden. Ein Ausfall um drei Uhr nachts wiegt anders als einer während der Hauptgeschäftszeit, und genau das muss ein aussagekräftiger Bericht abbilden.
Woher kommen die Daten und welche Werkzeuge sichern die Qualität?
Verlässliches Reporting braucht mehrere Datenquellen, die zusammenspielen: Monitoring-Systeme liefern technische Messwerte, Ticketing beziehungsweise ITSM-Tools dokumentieren Vorfälle und Reaktionszeiten, Logs liefern die Rohdaten für Nachvollziehbarkeit und eine CMDB ordnet alles den richtigen Services zu.
- Request-based Messung: bewertet jede einzelne Anfrage, eignet sich für Dienste mit hohem, gleichmäßigem Traffic.
- Window-based Messung: aggregiert über feste Zeitfenster, praktikabler bei schwankender Last oder seltenen Events.
Beide Methoden haben ihre Schwächen: Request-based reagiert empfindlich auf kurze Lastspitzen, window-based kann einzelne kurze Ausfälle verschlucken. Automatisierung über APIs und ETL-Strecken reduziert manuelle Fehler erheblich, und ein zentraler Datenbestand verhindert, dass Provider und Kunde am Ende über unterschiedliche Zahlen streiten, wie eine Analyse zur zentralisierten SLA-Berichterstattung beschreibt.
Profi-Tipp: Legen Sie eine einzige Quelle für jede Kennzahl fest, bevor Sie den ersten Bericht erstellen, sonst diskutieren Sie später über Zahlen statt über Ursachen.
Wie werden SLIs, SLOs und das Fehlerbudget im Bericht dargestellt?
Die technische Umsetzung folgt einem klaren Ablauf, den Azure Monitor in seiner Dokumentation zu Service Level Indicators beschreibt.
- Service-Gruppen definieren und die Grenze des überwachten Systems klar abstecken.
- Evaluationsmethode wählen: request-based für granulare Auswertung, window-based für aggregierte Compliance-Perioden.
- Compliance-Periode festlegen, etwa monatlich oder quartalsweise, passend zum vertraglichen Berichtszyklus.
- Error-Budget berechnen und das verbleibende Budget im Bericht als Trend-Chart abbilden.
Burn-Rate-Alarme geben Frühwarnungen, bevor ein SLO tatsächlich verletzt wird, wie Azure Monitor erläutert. Das verschiebt den Fokus vom reinen Rückblick zur vorausschauenden Steuerung, weil Teams reagieren können, solange noch Budget übrig ist, statt erst nach einem bereits eingetretenen Verstoß.
Welche Fehler schleichen sich in SLA-Berichte ein und wie lässt sich das vermeiden?
Die häufigste Falle ist das falsche Zeitfenster: Ein Ausfall wird gegen ein Kalenderfenster gemessen, das gar nicht dem vertraglich vereinbarten Business-Fenster entspricht. Ebenso tückisch sind Ticket-Workarounds, bei denen Mitarbeiter Vorfälle manuell umkategorisieren, um Zielwerte einzuhalten, was die Datenbasis verfälscht.
- Datenfragmentierung: Wenn Monitoring und Ticketing getrennt gepflegt werden, entstehen Lücken und Doppelzählungen.
- Fehlende Reproduzierbarkeit: Abfragen, die niemand nachvollziehen kann, untergraben das Vertrauen in den Bericht.
- Fehlender Audit-Trail: Ohne Protokoll, wer welche Zahl wann berechnet hat, lassen sich Streitfälle kaum klären.
Ein SLA-Überblick auf Wikipedia nennt Prüfmechanismen und Audits als feste Bestandteile eines funktionierenden SLA. Regelmäßige Review-Meetings mit Business-Stakeholdern, nicht nur mit der IT, schließen die Lücke zwischen technischer Messung und tatsächlicher Kundenerfahrung.
Wie sieht ein praktisches Template für SLA-Berichte aus?
Ein Bericht braucht keine hundert Seiten, aber eine feste Struktur, die jeder Empfänger sofort versteht. Laut einem Leitfaden zur SLA-Gliederung sollten Berichte Ersteller, Empfänger, Detaillierungsgrad und Frequenz von Anfang an festlegen.
- Executive-Summary: Ampelstatus und wichtigste Abweichung in drei Sätzen.
- Compliance-Summary: Zielwert gegen gemessenen Wert je SLO, inklusive Berichtszeitraum.
- Incident-Breakdown: Vorfälle mit Dauer, Ursache und betroffenem Business-Fenster.
- Maßnahmenliste: konkrete nächste Schritte mit Verantwortlichkeit und Termin.
Monatliche Berichte an operative Teams und quartalsweise Zusammenfassungen an das Management haben sich als Frequenz bewährt, weil sie beide Zielgruppen ohne Informationsüberflutung bedienen.
Wie vereinheitlicht digitalWAS Reporting-Daten in der Praxis?
Datensilos sind das größte Hindernis für vertrauenswürdige Reports, und genau hier setzt eine integrierte Plattform an. digitalWAS führt Ticketing, Zeiterfassung und Auswertungen in einer Umgebung zusammen, sodass Kennzahlen aus einer einzigen Quelle stammen statt aus getrennten Exporten. Die Datenhaltung erfolgt DSGVO-konform, was gerade für Audit-Trails und Nachweisführung relevant ist. Über 500 Unternehmen nutzen die Plattform bereits für ihre täglichen Betriebsabläufe, dokumentiert mit einer 5,0-Bewertung auf Google.
 KI-generiertes Bild
Warum SLA-Reporting allein nicht reicht
Ein Bericht kann grün leuchten, während Kunden trotzdem unzufrieden sind. Genau dieses Muster beschreibt ein Beitrag im ITIL-Blog: erfüllte SLAs garantieren keine zufriedenen Nutzer. Wer nur Uptime und MTTR verfolgt, misst die Technik, nicht die Erfahrung. Eine Ergänzung durch Experience-Level-Kennzahlen und eine bewusste Iteration der SLOs anhand des tatsächlichen Geschäftsimpacts liefert ein ehrlicheres Bild, als es reine Zielerreichung je könnte.
— Tom
Diskrete Lösung: SLA-Reporting mit digitalWAS umsetzen
Wer SLA-Daten aus mehreren Tools zusammenführen muss, verliert dabei oft Zeit, die besser in Analyse und Maßnahmen fließen sollte. digitalWAS bündelt Ticketing, Zeiterfassung und Auswertungen in einer Plattform, wodurch Reports ohne manuelle Zusammenführung entstehen.
- digital scaleUp: integriert CRM, Tickets und Auswertungen für KMU in einer Oberfläche.
- Managed IT: übernimmt Betrieb und 24/7-Hotline, wenn interne Kapazitäten fehlen.
- KON-VAULT: verwaltet Zugänge und Zugriffsschlüssel Ende-zu-Ende verschlüsselt, relevant für sichere Log- und Systemzugriffe im Reporting-Alltag.
Wer den administrativen Aufwand hinter SLA-Berichten reduzieren möchte, findet auf der Produktseite von digital scaleUp den passenden Einstieg.
Quellen
Die ISO/IEC 19086, die Azure Monitor Dokumentation und die genannten Leitfäden bilden die fachliche Grundlage dieses Artikels.
- Service-level agreement — Wikipedia
- ISO/IEC 19086 — ISO
- Service level indicators (SLIs) - Azure Monitor
FAQ
Was versteht man unter SLA?
Ein SLA ist ein formeller Vertrag zwischen Anbieter und Kunde, der die zugesicherte Leistung festlegt, wie Wikipedia erläutert. Er definiert Rahmenbedingungen wie Verfügbarkeit, Reaktionszeiten und Konsequenzen bei Nichteinhaltung.
Was ist der Unterschied zwischen SLA und KPI?
Das SLA ist der Vertrag als Ganzes, während der KPI die konkrete Messgröße ist, mit der die vertraglich zugesicherte Leistung überwacht wird. Ein KPI liefert also die Zahl, das SLA den rechtlichen Rahmen dahinter.
Was bedeutet SLA auf Deutsch?
SLA steht für Service Level Agreement, zu Deutsch Dienstleistungsvereinbarung oder Servicevereinbarung. Der deutsche Begriff wird in Berichten seltener verwendet, da sich die englische Abkürzung im IT-Umfeld durchgesetzt hat.
Was ist der Unterschied zwischen SLA und SLO?
Das SLA ist der Vertrag, das SLO das darin enthaltene, messbare Ziel, etwa eine Verfügbarkeit von 99,9 %. Ein SLA kann mehrere SLOs enthalten, die jeweils einzeln im Bericht ausgewertet werden.
Wie oft sollte ein SLA-Bericht erstellt werden?
Monatliche Berichte für operative Teams und quartalsweise Zusammenfassungen für das Management haben sich in der Praxis bewährt. Die passende Frequenz richtet sich nach dem vertraglich vereinbarten Berichtszyklus und der Zielgruppe des Reports.